
AI 眼里的我们长什么样:一次 GEO 采集的复盘
我想知道客户在 DeepSeek 或豆包里搜索时,AI 会怎么描述一家本地门店。为此我写了一个采集 Skill:用真实浏览器逐题提问,把回答、引用链接、截图全部存成可回溯的证据。这篇复盘设计思路、实现边界,以及为什么采集只是第一步。
Why I built an AI answer harvesting skill: asking real browsers the questions customers would ask, capturing answers, citations and screenshots as traceable evidence, and why harvesting is only the first of three stages.
做 GEO 这件事,绕不开一个很朴素的问题:客户真的会去问 AI,那 AI 到底怎么回答。
这个问题不能靠猜。你不能假设「AI 应该知道我们」,也不能拿自己问自己得出的结论当证据。得真的去问,而且得把 AI 说了什么、引用了什么、什么时候说的,全部原样留下来。
三个月前我开始做这件事。这篇复盘讲清楚三件事:为什么这么设计、现在做到了哪一步、以及中间踩了哪些坑。
先说清楚这件事的边界
整套东西我分成三个阶段,目前只完成中间那一段。
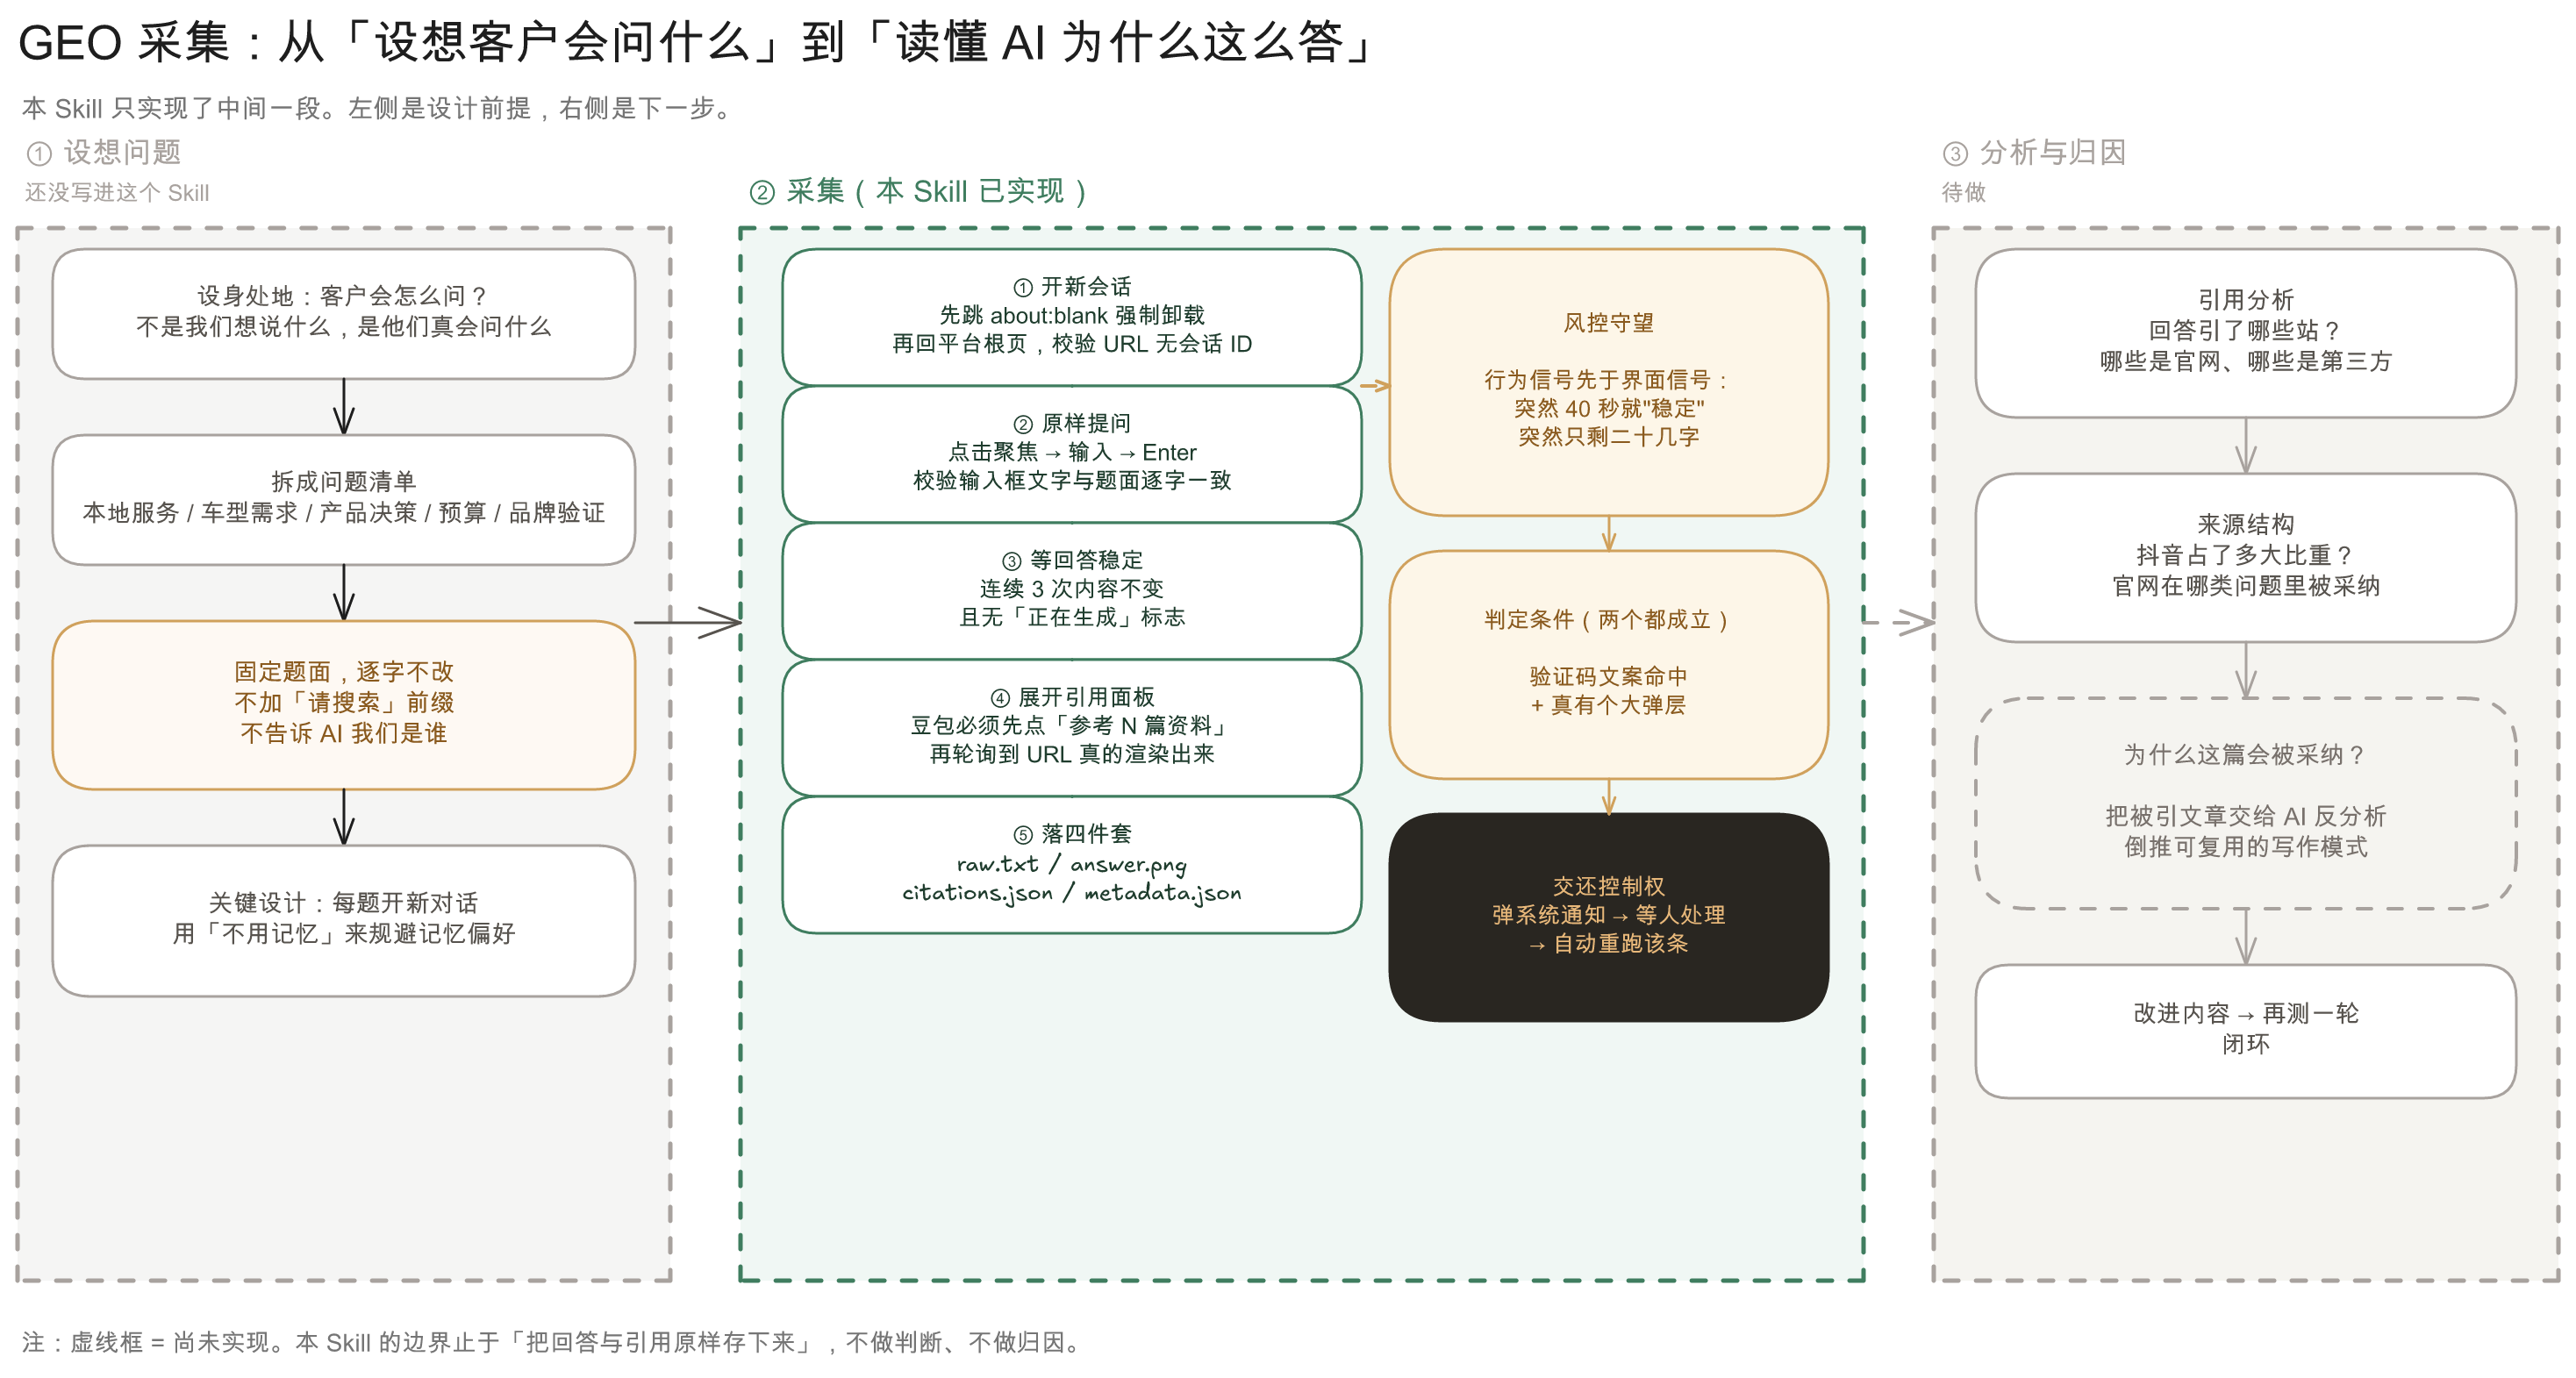
左边是设想问题——先想清楚客户会怎么问。这一步还没有沉淀成工具,是我人工在做。
中间是采集——把 AI 的回答和引用原样抓下来。这是已经写完的 Skill。
右边是分析与归因——回答引用了哪些站、为什么这些内容能被采纳。这一步还没开始。
所以这个 Skill 的能力边界很明确:它只负责采集,不做判断,不做归因。
第一阶段:先想清楚客户会问什么
这是整个设计里最容易被跳过的一步,但它是地基。
如果自己做产品,很容易想的是「我们的无尘车间多厉害」;但客户实际搜的是「顺德贴车衣哪家好」。这两句话之间隔着巨大的鸿沟,而 AI 只回答后一种。
所以我先把问题按场景拆开:本地服务类、车型需求类、产品决策类、预算优先级类,还有品牌验证类。每一类都对应客户在不同阶段真正会问的话,而不是我们想说给别人听的话。
拆完之后有几个纪律:
题面固定,逐字不改。 一旦某一次加了个「请搜索」的前缀,这一条就没法和别的比了。
不告诉 AI 我们是谁。 你只要说一句「我们是佛山一家汽车改装店」,AI 后面的回答就变成了顺着你说的,基线就失去了意义。
关键设计:每题开一个新对话
这一条是我最想强调的。
AI 对话产品都有记忆。你在同一个会话里继续问,它会带着上文回答。对日常使用这是好事,对基线测试是灾难——上一题的上下文会渗进下一题,你测到的就不再是「AI 面对这个问题会怎么答」,而是「AI 在被我引导之后会怎么答」。
所以我的做法是:每一个问题都开一个全新的对话,把记忆这条变量直接掐掉。
这不算什么高深的技术,但它是一个明确的取舍。代价是每道题都要重新加载页面,整体慢了不少;好处是每次观测都是干净的。
第二阶段:采集怎么做
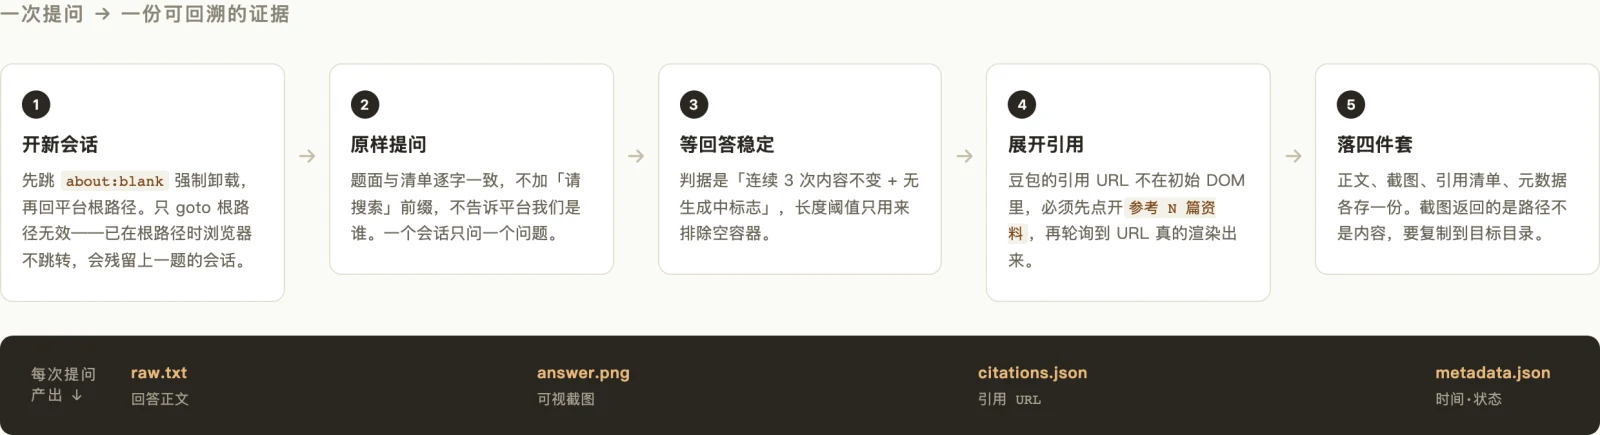
采集这一段的链路是五步。
为什么要用浏览器,而不是调 API
这里要说清楚一件事:我用的是真实浏览器,不是官方 API。
原因有三个。
第一,API 和网页端不是同一套东西。API 通常没有联网检索,回答的是模型内部知识;网页端才会去搜、去引、去给你参考资料列表。而我要测的恰恰是「联网之后 AI 怎么说」,API 给不了这个。
第二,引用链接是网页端的产物。我问的不只是「AI 说了什么」,而是「它凭什么这么说」。这个「凭什么」体现在参考资料列表里,而只有网页端才有。
第三,要贴近真实用户。客户是在网页里输入的,账号状态、地域、是否登录,都会影响返回的结果。用浏览器就自动继承了这些条件。
为什么浏览器能被程序控制
这里解释一下,因为很多人会好奇「程序怎么读得到网页里的东西」。
我用的浏览器是 ego-lite,它本质上是 Chromium 加了一个调试接口。这个接口叫 CDP,Chrome DevTools Protocol,浏览器开发者工具的底层协议。
它的能力包括:
- 读到页面的 DOM 结构,也就是页面渲染出来的全部元素
- 在页面里执行 JavaScript,可以查询元素、读取文本、触发点击
- 截取页面图像,也就是截图
- 接管一个已经登录的浏览器实例,不需要每次重新登录
最后一条很关键。我不需要把账号密码交给程序,只要我自己在这个浏览器里登录过,程序操作时就是在用我这个登录状态。
具体到读数据,大概是这样几层:
// 读回答正文:找到回答容器,取它的可见文本
const text = document.querySelector('.ds-assistant-message-main-content').innerText

// 展开引用面板:先找到触发按钮
const btn = [...document.querySelectorAll('div,span,button')]
  .find(e => /^搜索 \d+ 个关键词,参考 \d+ 篇资料$/.test(e.innerText.trim()))
btn.click()

// 引用链接有时候不在 DOM 里,藏在框架的内部状态
// 这时要顺着 React 挂载的节点往上找
let el = container, depth = 0
while (el && depth < 6) {
  const key = Object.keys(el).find(k => k.startsWith('__reactFiber$'))
  if (key) { /* 从 el[key] 里扫出 URL */ }
  el = el.parentElement; depth++
}
最后那段深度限制 6 层是踩出来的。不限制的话会一路回溯到祖先节点,把兄弟节点的 URL 也挖出来——搜索结果里混进了搜索供应商的图标域名。
四个平台,四套完全不同的页面
我原以为「AI 对话产品」结构应该差不多。实测下来,没有一处相同:
| 项目 | DeepSeek | 豆包 | Kimi |
|---|---|---|---|
| 输入框 | 标准 textarea | 富文本编辑器 | 富文本编辑器 |
| 回答容器 | 精确类名 | 模糊匹配取最长 | 未知 |
| 引用位置 | 框架内部状态 | 点开面板后扫全页 | 未知 |
| 联网标志 | 页数角标 | 参考篇数文案 | 未知 |
光输入框这一项就够说明问题:DeepSeek 用标准 textarea,可以直接输入文字;另外两家全是富文本编辑器,得先点击聚焦再输入。
所以每换一个平台,探测页面结构这一步不能省,也没法复用。
输出的东西:三个文件
每次提问产出三个核心文件,加上一张截图。
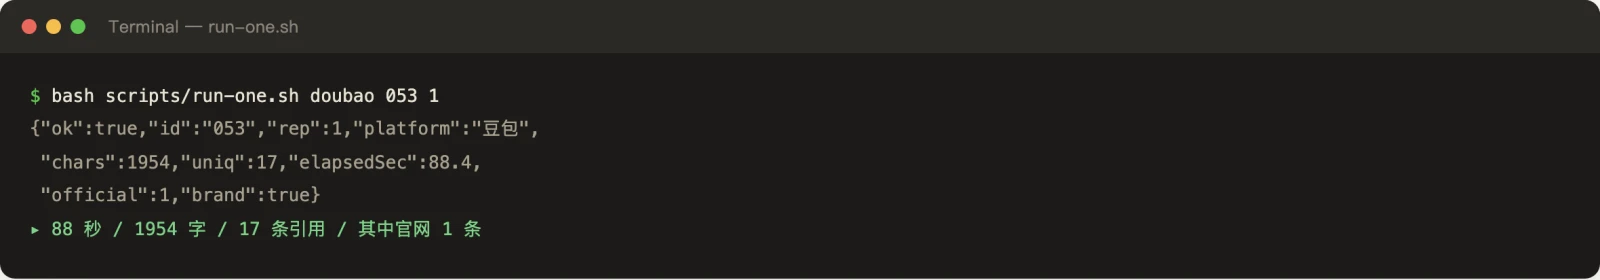
跑一条题大概是这样:88 秒,拿到 1954 字回答、17 条引用链接,其中来自官网的只有 1 条。
产物目录长这样:
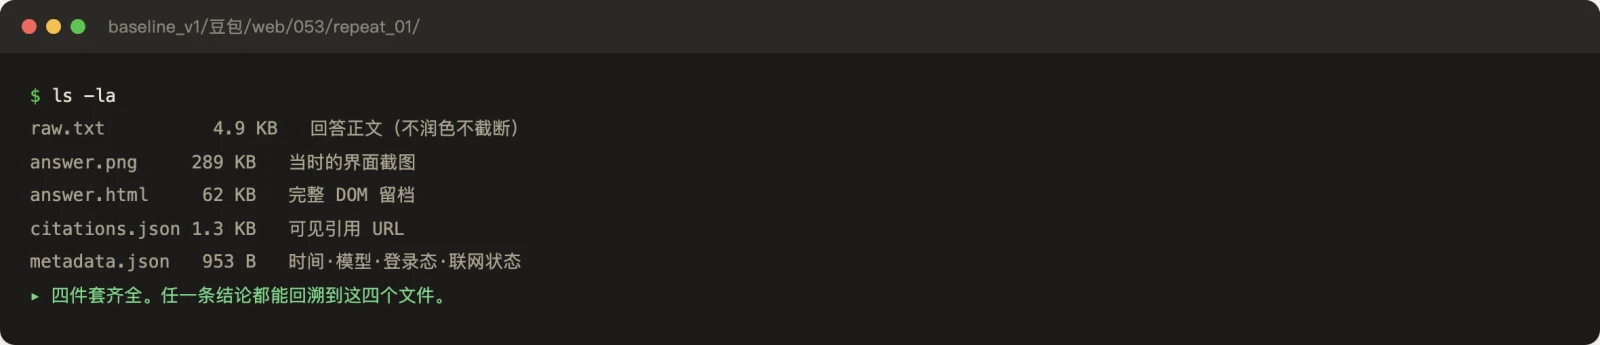
三个核心文件各有分工。
raw.txt 是回答正文。它必须是完整的、未润色的原文,不能摘要、不能截断。因为下一步做引用分析时,需要拿原文去比对。
citations.json 是引用链接清单。这是每一条结论的证据。
metadata.json 是这次观测的条件。什么时候问的、哪个平台、是否联网、账号什么状态、网络出口在哪。没有这些,「AI 说过这话」就是一句话;有了这些,它才是一条可复核的记录。
采集数据的实际形态
引用清单里到底长什么样,看一条真实的:
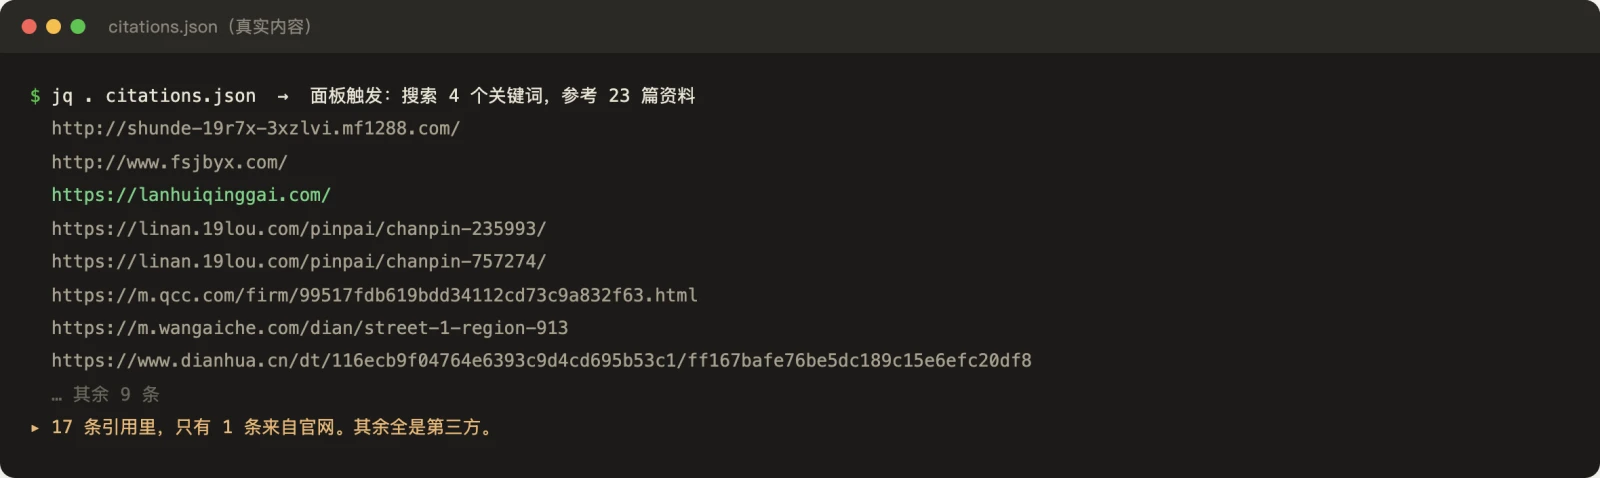
这条题问的是「佛山顺德汽车轻改装门店推荐」。AI 参考了 23 篇资料,最终引用 17 个链接。
17 条里,官网只占 1 条。剩下的是本地生活平台、同行网站、电话号码库。
这个结构本身就是结论的一部分:在这个问题类型下,AI 主要信第三方,而不是信你。
看起来成功,其实全错
这一类问题比技术 bug 危险得多,因为计数器是绿的。
存了 22 个字的「回答」
风控发生的时候,平台的表现是这样的:用户消息发出去了,页面上出现题面加一个时间戳,但 AI 的回答没有生成。
采集器在等回答稳定,看到页面内容不再变化、长度大于 20(题面加时间戳正好 22 个字),判定「稳定」,然后把这个存成了回答。
于是 raw.txt 里躺着 22 个字,ok: true,日志全绿。
更糟的是品牌判定——因为那 22 个字里没有品牌名,这条记录被统计成「AI 没有提到品牌」。
脏数据就这样安静地进了数据集,而且看起来完全正常。
后来加了两道防线:回答少于 120 字直接判失败;重跑清单里把不足 200 字节的记录也算作待跑。
「无引用」不等于「没检索」
豆包有一类问题是纯知识问答,比如「打蜡和镀晶哪个划算」。AI 直接凭内部知识回答,压根没触发搜索,当然没有引用。
这跟「检索了但没找到」是两回事。
所以采集器里对这两种情况的做法是:没有引用面板就存 null,表示「这次没测到联网状态」,而不是存 false 表示「没联网」。差别看起来细微,但统计时一个进分母一个不进,结果完全不一样。
反风控:行为信号比界面信号更早
风控最难的地方在于它不总是显式出现。界面上可能什么都没有,账号还是登录状态,但 AI 就是不回答了。
所以判据不能只看界面,我用了两层。
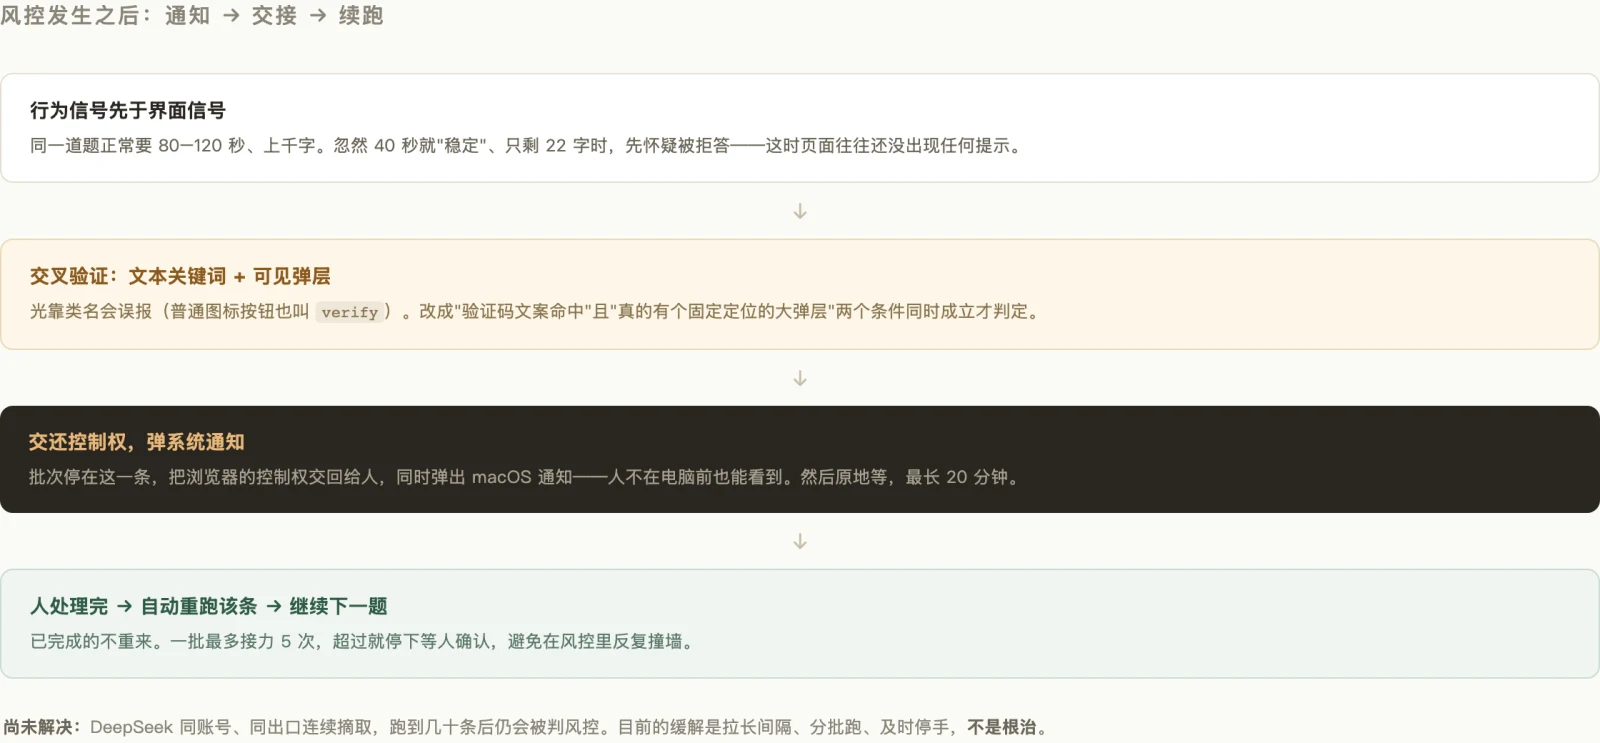
第一层是行为。 同一道题正常要 80 到 120 秒、上千字。忽然 40 秒就稳定、只剩二十几个字,先怀疑被拒答。
第二层才看界面。 而且不能用类名判断——我试过匹配含 verify 的类名,结果页面上两个普通图标按钮也被命中。改成两个条件同时成立才算:文本里有验证码文案,并且确实存在一个固定定位、有实际尺寸的大弹层。
判定之后不是停批重来,而是交还控制权:把浏览器还给用户,弹一个系统通知,原地等人处理完,然后自动重跑这一条继续往下走。
这个机制实测跑通过一次。但要说清楚:它只是缓解,不是根治。
还没解决的问题
DeepSeek 同账号、同出口连续采集,跑到几十条之后仍然会被判风控,跳回登录页或者直接不回答。
目前的缓解手段是拉长间隔、单批控制条数、检测到异常立刻停手。真正的解法还没写出来。可能的方向有几个:多账号轮换、拉长到跨天分批、或者先把平台侧能改的东西改完再复测。
在解决之前,所有采集结论都要带着这个前提读:这是特定日期、特定网络出口、单次重复下的观测,不能外推成长期排名。
这套东西里哪些是我定的
工具能跑起来是一回事,怎么跑是另一回事。有几处是我自己拍的板。
「每题新开对话」是我定的,不是平台的默认。 平台巴不得你接着聊,那样体验最好。但基线测试不能要这个,上下文一污染,后面所有结论都不可信。
用浏览器而不是 API,是我定的。 走 API 更快、更稳定、不用处理页面结构。但 API 没有联网检索、没有引用列表,测不到我要的东西。宁可写起来麻烦,也要拿到真实形态。
三个文件的分工是我定的。 最初只存回答正文,后来想想没法复核,才把引用和元数据分出来。分开之后才发现,引用这一项才是最有价值的。
最费判断的是那几条阈值。 回答多少字算异常、耗时低于均值多少算可疑、一批跑多少条该停——这些没有标准答案,只能拿实际数据反复调。第一版设太严,正常短回答被判成失败;第二版设太松,风控期间的残渣又混了进来。
几个刻意的取舍
没有做并发。 从效率看,几个平台同时跑能省一大半时间。但并发是最容易被判风控的行为,一旦封了,前面跑的全白费。所以我选择串行,慢但稳。
没有做「回答自动摘要」。 有现成的模型可以帮忙压缩回答,看起来能让数据更好读。我放弃了——摘要会引入第二层失真,而这份数据的全部意义就是原样。
没有把「无引用」写成「没检索」。 这两种情况我都遇到过,外观一样但含义相反。我选择存 null 表示「没测到」,而不是猜一个默认值填进去。代价是统计时要单独处理空值,好处是不会造出假结论。
下一步:让 AI 帮我分析为什么
采集跑完,真正有意思的问题才开始。
现在我知道 AI 引用了哪 17 条链接,也知道官网只占 1 条。但为什么?为什么同行那篇文章被引用了,官网那些品类页没有?
这一步我打算交给 AI 自己来做:把被引用的文章正文交给 AI,让它反推——这篇文章满足了什么条件才被采纳?结构上有什么特征?信息颗粒度到什么程度?
拿到这些模式,再回头改内容,然后重测一轮,看指标有没有变化。这才是闭环。
但这个环节还没开始写。所以现在这套东西的定位很清楚:它是一个采集器,不是一个分析系统。
采集部分目前跑完 DeepSeek 一百九十四条、豆包九十二条。四家平台里 DeepSeek 和豆包已经跑通,通义千问和 Kimi 的选择器还没探完。
如果你也想跑自己的品牌,需要准备三样东西:一份问题清单、各平台的登录态、以及一个和目标客户同地域的网络出口。第三样比看起来重要——从外地问「顺德哪家好」,拿到的答案是没有意义的。