
6.5 重构, 在项目中使用SQLite
项目重构:把原来的文件存储换成数据库存储。
课时概要
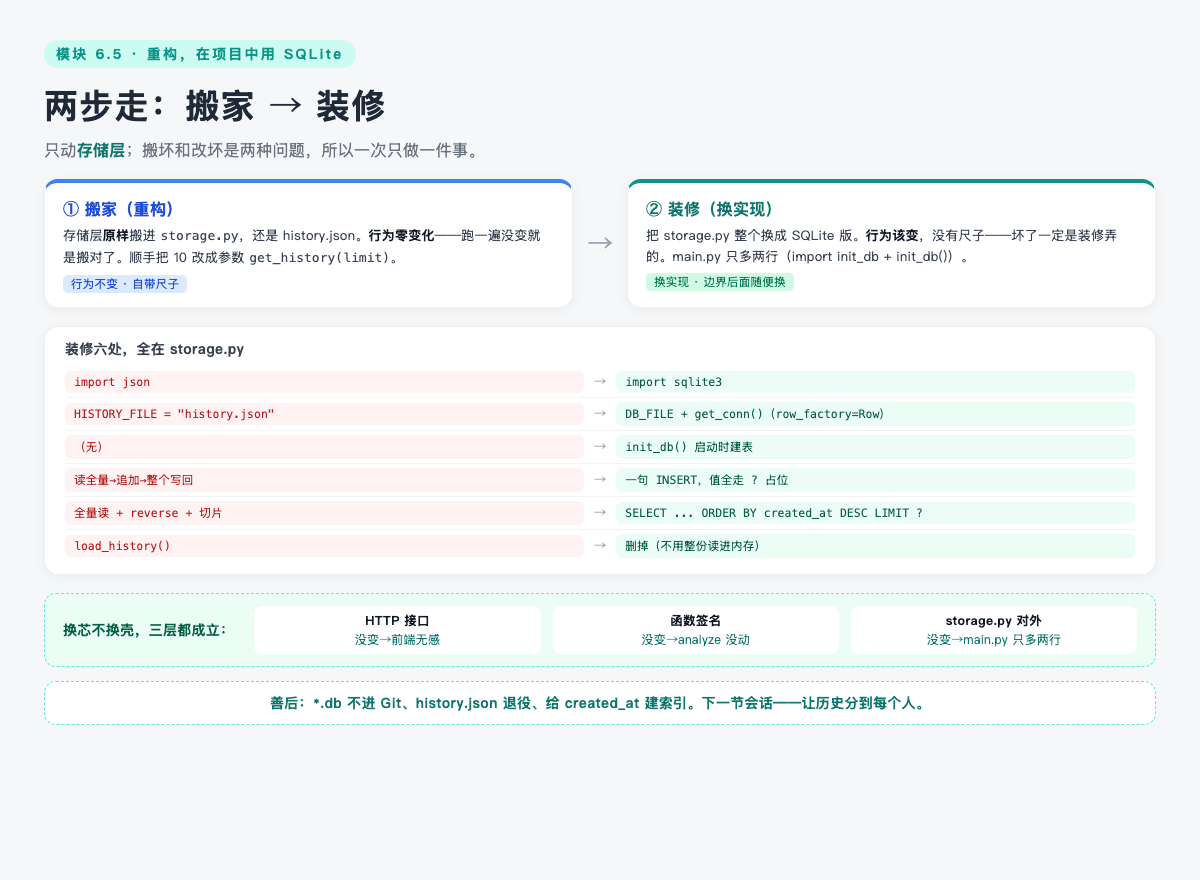
把项目的存储层从 history.json 文件换成 SQLite。只动存储层,接口约定不变,前端毫无察觉。先给 main.py 分层(接口/业务/存储),把存储层单独拆成 storage.py;再分两步走:搬家(功能零变化)→ 装修(换成 SQLite 实现)。善后:.db 不进 Git、建索引、认识 ORM。
以上为 UP 主的 B 站官方简介,非观看笔记;只有跟完这一节才算自己的理解。
视频:【零到全栈】6.5-重构, 在项目中使用SQLite | 时长 45:51 | 模块 6 · 生态、数据与状态
讲义:模块 6.5:重构,在项目中使用 SQLite(李勃老师.com)
本节要点
- 三层职责:接口层(@app 路由)/ 业务层(算分拼结果)/ 存储层(存哪、怎么存取)。分层分的是职责,不是文件。
- 重构铁律:外部行为一点不能变——只挪位置不改行为,跑出来不一样就是搬错了。
- 两步分开做:①搬家(存储层原样搬进 storage.py,自带「跑一遍没变」的尺子);②装修(换成 SQLite,行为该变)。混在一起就分不清是搬错还是换错。
- 动作归存储层,决定归调用方:
get_history(limit)把「要几条」的数字交出去,存储层只说「你要几条我给几条」。 - 装修六处全在 storage.py:换 import / get_conn()(row_factory=Row)/ init_db() 建表 / save_record 一句 INSERT / get_history 一句 SELECT ORDER BY LIMIT / 删掉 load_history。
- main.py 只多两行(import init_db + init_db())。
- 善后:
backend/*.db不进 Git;history.json 退役;ORM 认脸;给 created_at 建索引。
笔记正文(讲义整理)
为什么要分层
/api/history 里那三行(全量读→reverse→切片)是取数据的手法,本该在存储层,却长在接口函数里。分层不清晰的代价:要换存储就不得不改接口函数。
第一步:搬家(重构,行为不变)
新建 backend/storage.py,把存储层原样剪切过来,包括把那三行包成 get_history()。main.py 只做四件事:import storage、删掉搬走的三样、/api/history 瘦身为 return get_history(10)、其余不动。
顺手把写死的 10 改成参数:
get_history(limit),调用方传 10。动作归存储层,决定归调用方——存储层不该管手机上要显示几条。
第二步:装修(换实现)
六处改动全在 storage.py:
| # | 文件版 | SQLite 版 |
|---|---|---|
| 1 | import json | import sqlite3 |
| 2 | HISTORY_FILE = "history.json" | DB_FILE="history.db" + get_conn()(row_factory=Row,结果带列名) |
| 3 | (无) | init_db():建表(先定结构再放数据) |
| 4 | save_record:读全量→追加→整个写回 | 一句 INSERT(值全走 ? 占位) |
| 5 | get_history:全量读+reverse+切片 | 一句 SELECT ... ORDER BY created_at DESC LIMIT ? |
| 6 | load_history | 删掉(不用整份读进内存) |
main.py 只多两行:from storage import init_db, ... 和启动时 init_db()。
验证 + 换芯不换壳
前端一行没改,接口/函数/文件三个尺度各成立一次:
- HTTP 接口没变 → 前端毫无察觉;
save_record()/get_history()签名没变 → analyze 没动;- storage.py 对外样子没变 → main.py 只多两行。
别被
fetchall的 "all" 骗了:它是「SQL 查回来的全部」,LIMIT 10 就只 fetch 10 条。
善后四件事
backend/*.db加进.gitignore——数据是运行时产生的,不进 Git(和 node_modules/.venv/out 同类);history.json退役删掉(没上线,不用做数据迁移);- ORM 认脸(SQLAlchemy 把表包装成 Python 对象、自动生成 SQL)——我们两句 SQL 手写更清楚;
- 给
created_at建索引:CREATE INDEX IF NOT EXISTS idx_history_created ON history(created_at)——常排序的列才建,别什么字段都建。
和 GFG / 课程笔记的连接
| 这节内容 | GFG / 已学 |
|---|---|
| 分层/重构 | 4.1 模块化的后端版;分层分的是职责不是文件 |
| sqlite3 用法 | GFG 的 sqlite3 章节;connect/cursor/execute/commit 全套 |
| row_factory=Row / dict(row) | 把元组变字典——和 GFG 里 Row factory 概念对上 |
| 「动作归存储层,决定归调用方」 | 接口设计思维;和 5.1「约定」一脉 |
| 索引 | 6.4 讲过,今天亲手建出来,DB Browser 里能点开看 |
这节是 4.1「模块化」在后端的重演:前端拆组件,后端拆层——都是「边界立住,里面随便换」。
关键概念
- 重构:不改外部可观察行为,只调内部结构(搬家);换实现不算重构。
- 三层:接口层 / 业务层 / 存储层。
- row_factory=Row:让查询结果带列名,可 dict(row) 转成要回前端的 JSON 形状。
- init_db():启动时确保表在(CREATE TABLE IF NOT EXISTS)。
- ORM:把表包装成 Python 对象、自动生成 SQL(SQLAlchemy)。
- 索引:
CREATE INDEX ... ON history(created_at),常排序列才建。
代码 / 实操
# backend/storage.py 要点
import sqlite3
DB_FILE = "history.db"
def get_conn():
    conn = sqlite3.connect(DB_FILE)
    conn.row_factory = sqlite3.Row
    return conn
def init_db():   # main.py 启动时调一次
    # CREATE TABLE IF NOT EXISTS history (...)
    # CREATE INDEX IF NOT EXISTS idx_history_created ON history(created_at)
def save_record(record):
    # INSERT INTO history (...) VALUES (?, ?, ?, ?, ?), [...]; commit; close
def get_history(limit):
    # SELECT * FROM history ORDER BY created_at DESC LIMIT ?; dict(row)
# .gitignore 加:backend/*.db
我的收获
- 两步走(搬家→装修)不是教条:分开做,出了问题范围才小——搬坏了还是改坏了一眼分清。
- 「动作归存储层,决定归调用方」:把 10 改成参数,看似挪个数字,其实是把职责划对。
- 整个存储层从 JSON 文件换成数据库,前端零改动——边界立住,地板下面天翻地覆页面也纹丝不动。
待深入
(待填:没听懂、想回头查的。)